散
资料分散
文档、Jira、数据库、文件夹和业务系统各自独立,员工查资料成本高。
面向客服、售前、运维、研发和内部员工,统一连接文档、知识库、Jira、数据库、文件和 API,让用户用自然语言就能获得带依据的答案。
系统先检索企业知识库,再通过 ReRank 精排筛选最相关资料,最后由大模型生成标准处理步骤,并返回引用来源。
针对知识分散、检索低效、答案不可追溯等问题,产品提供从知识构建到可信问答的完整能力。
文档、Jira、数据库、文件夹和业务系统各自独立,员工查资料成本高。
客服、售前、运维等团队经常重复查文档、问同事,影响问题处理效率。
普通搜索只看关键词,普通大模型容易凭空生成,难以稳定命中真实资料。
答案没有引用来源,业务人员难以判断内容是否可信、是否可执行。
灵活适配各类知识库,让企业知识与服务持续沉淀为可复用资产
左右滑动查看完整对比表
| 核心优势 | ReRank + MCP 架构能力 | 传统云端知识库方案 |
|---|---|---|
| 本地知识库适配不同知识库 | 通过 MCP 统一接口与适配层,连接各类云端知识库产品及本地知识库,支持按业务需求灵活选配、组合与替换。 | 通常围绕平台自身知识库使用;跨产品连接与替换,依赖平台开放能力。 |
| 企业资产沉淀知识长期积累 | 将制度、项目文档、业务经验持续整理为可检索、可维护、可复用的知识资产,降低对单一知识库产品的依赖。 | 知识更多沉淀在平台知识空间中;跨平台复用与长期迁移,受平台机制影响。 |
| 能力资产沉淀接口与流程复用 | 将检索、重排、业务查询封装为 MCP 服务,供不同助手与应用复用,持续积累企业专属工具与服务体系。 | 连接器与问答流程通常围绕平台配置;切换平台时,往往需要重新适配。 |
| 知识与业务融合文档结合实时信息 | 连接知识库、数据库、文件、Jira 与业务 API,让回答同时利用文档依据与当前业务状态,从查资料延伸到解决业务问题。 | 以文档导入和定期同步为主;实时业务查询,通常需要额外扩展。 |
| 精准检索与追溯让知识资产更好用 | 向量召回 → ReRank 精排 → 证据筛选 → 引用,提升内容相关性,支持核验回答依据,提高企业知识的利用效率。 | 检索策略与引用能力由平台提供;深度优化空间,取决于平台开放程度。 |
对比基准:以文档托管和平台内问答为主的传统云端方案;具体产品能力存在差异。
不止服务个人任务,更面向企业构建可持续积累的知识体系:支持本地知识库、ReRank 精排、知识自动更新与权限审计。
左右滑动查看完整对照,左侧功能名称保持可见。
| 对比项目同功能口径 | 我们的方案方案能力 / 实施条件 | WorkBuddy原生能力 / 外部依赖 | 飞书 Aily现“豆包工作伙伴” |
|---|---|---|---|
| 本地知识库接入 | ✓ 支持 本方案支持本地知识库;数据源接口与运行环境需按项目适配。 |
↗ 原生无* · 需外接 未列明本地知识库原生接入器;可安装自建或三方 MCP 服务。原生资料库支持上传文件,但不等于本地知识库。 |
— 不支持* 已查文档列明飞书知识、本地文件上传和服务台;未列明已有本地知识库原生直连,不把文件上传视为本地知识库。 |
| 知识存储与管理 | ✓ 方案内提供 知识构建、索引与管理纳入方案,可承接已有知识资产。 |
◐ 原生资料库 + 三方知识库 已有原生资料库,支持团队共享、检索、编辑;乐享知识库管理需接入独立的腾讯乐享产品,不能说全部原生无。 |
✓ 原生支持 知识空间内管理知识、切片、术语和检索规则,无需另接三方知识库才能使用。 |
| ReRank 二次排序 | ✓ 支持 语义召回后进行 ReRank 精排,筛选相关证据。 |
— 不支持* 已查资料库、连接器文档未列明原生 ReRank;仅有检索能力不作为精排证据。 |
✓ 原生支持 问答节点出参 recallScore 明确为“重排后的召回分”,不能标为没有重排能力。 |
| 自定义重排策略 | ✓ 支持定制 按业务调整筛选与排序策略,实际效果通过业务问题验收。 |
— 不支持* 已查文档未列明原生重排参数或策略配置;不能由自定义连接器直接推断开箱即用。 |
◐ 调优部分支持 支持术语、文档过滤、检索模式和切片数量;未列明自定义重排模型或策略,该子项按不支持*计。 |
| 知识服务跨应用复用 | ↗ 按需实施 将检索、重排及业务查询封装为 MCP 服务,接入不同助手与应用。 |
↗ 原生发布无* · 需外接 原生可调用三方 MCP;已查文档未列明把自身知识检索发布为服务,需另建或接入共享知识服务。 |
◐ 原生支持 · 有范围限制 工作流可发布 MCP,官方列明 aily、自定义智能体及工作流内调用;外部系统可走付费版本 API / SDK,不是必须接三方产品。 |
| 答案与切片来源展示 | ✓ 支持 答案保留文档、片段或记录来源,展示方式纳入交付验收。 |
— 不支持* 可把文件添加到任务,但已查文档未列明答案行内引用与命中切片的结构化对应;此处不等于完全无法引用文件。 |
✓ 原生支持 可显示行内及末尾参考链接;输出 knowledgeChunks、hitChunk 和 references。 |
| 多源知识自动更新 | ✓ 支持 同步频率、增删更新规则与维护责任按数据源设计。 |
◐ 原生改写 · 外部按需读取 原生资料库可持续读写;连接器明确“不主动定时抓取”,外部知识维护依赖所接产品或另配自动化。 |
◐ 部分支持 飞书云文档等可准实时同步;部分导入文件需启用每日同步,目录节点删除等仍有手动同步限制。 |
| 权限继承与审计 | ✓ 支持 支持按企业角色、资料范围配置权限与审计。 |
◐ 支持权限 · 统一审计无* 原生资料库人与 Agent 同权限,三方连接独立授权;已查文档未列明跨系统统一审计。 |
◐ 模式有别 · 统一审计无* 直连校验文档可搜权限;导入按应用用户范围可搜。已查文档未列明跨系统统一审计,运行日志不等同于统一审计。 |
将知识管理、语义检索、ReRank 精排、答案生成与来源复核融入六步问答流程,通过 MCP 统一连接知识与业务系统。
导入 PDF、文档、制度与业务资料,完成切分、向量化及索引,持续维护可复用的知识资产。
核心能力 · 知识构建与管理用户用自然语言提出业务问题,系统理解问题语义,作为后续检索的输入,无需复杂检索语法。
问答入口 · 自然语言提问从知识库中召回语义相关的候选内容,例如 Top 20,减少对精确关键词匹配的依赖。
核心能力 · 语义检索召回对候选资料与问题的相关性进行二次判断,将真正有用的内容排在前面。
核心能力 · ReRank 精排保留最相关的少量资料作为可信上下文,减少噪声,并保留对应的文档与片段来源。
证据筛选 · 为生成与引用提供依据大模型基于筛选后的企业知识生成结构化答案,同时展示文档、片段或系统记录,便于核查。
核心能力 · 答案生成 + 来源复核通过统一协议连接企业知识与业务服务,为知识获取、检索和答案生成提供按需调用能力,而非单独的一步处理。
第 1 步为问答前的知识准备,并持续更新;第 2—6 步为单次问答链路。Top 20 / Top 5 为示例参数,可按场景调整。
从重复咨询高、资料多、标准答案明确的场景切入,最容易体现投入产出比。
本方案可以作为企业 AI 应用的统一入口:先承载知识问答,再逐步连接业务流程和系统工具。
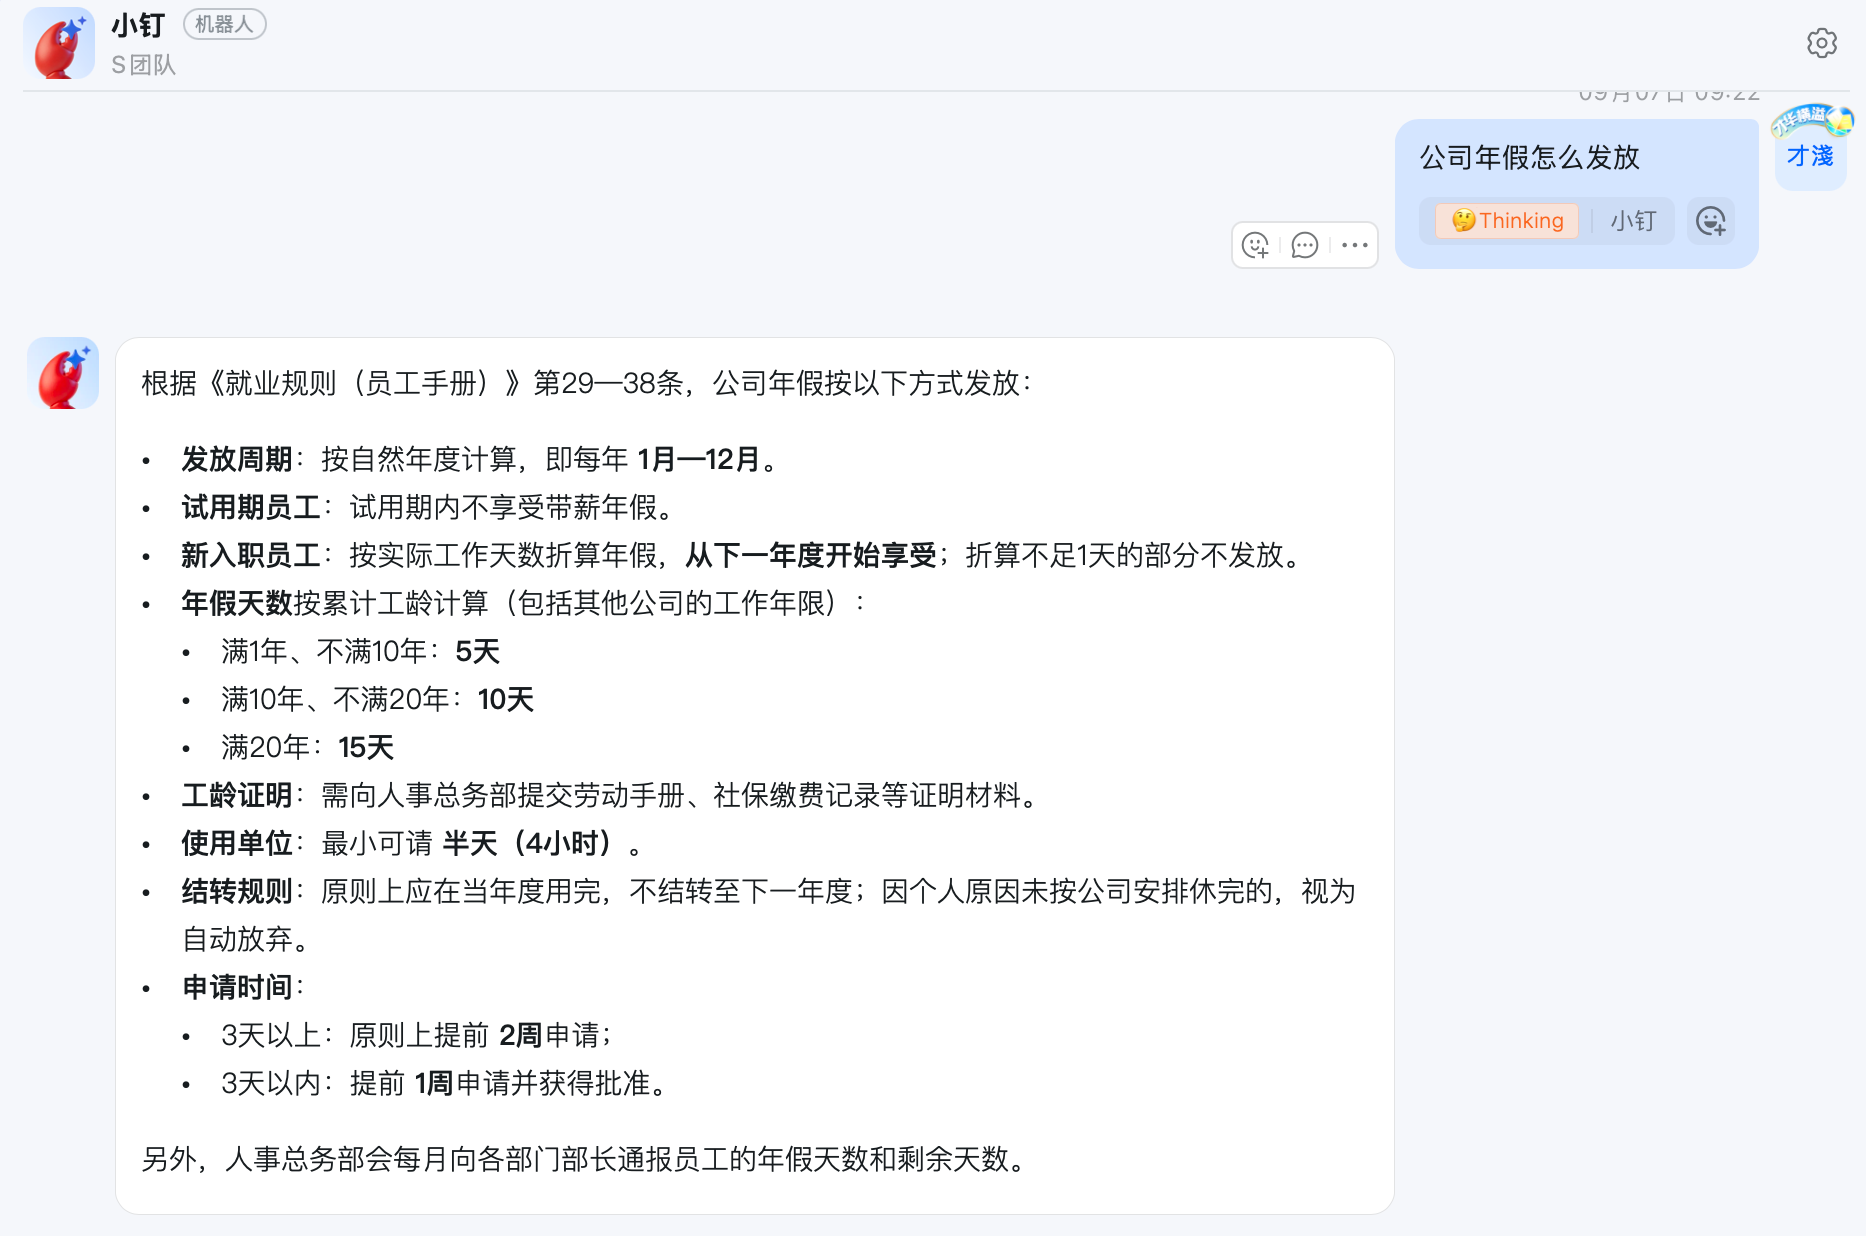
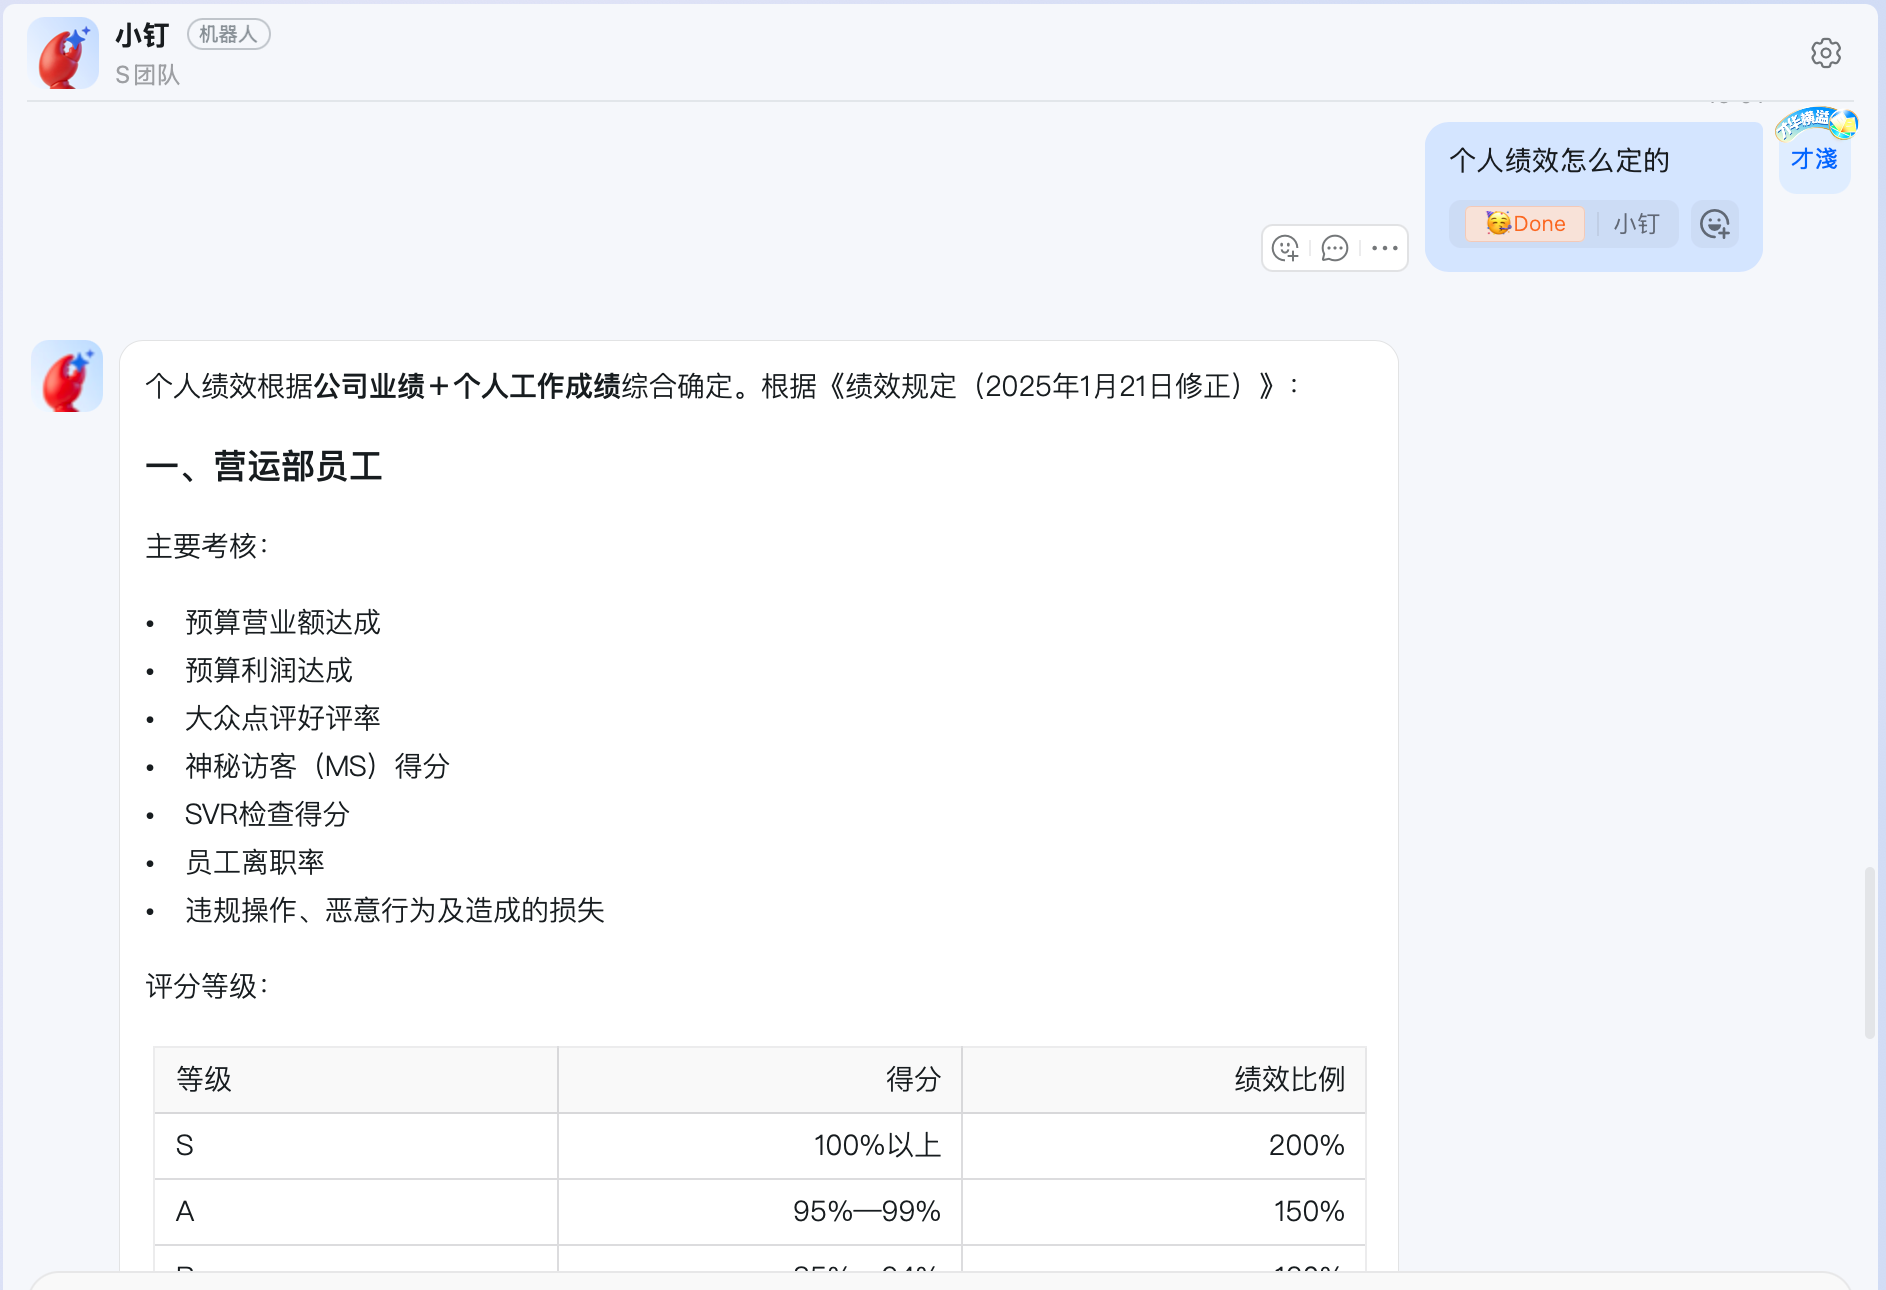
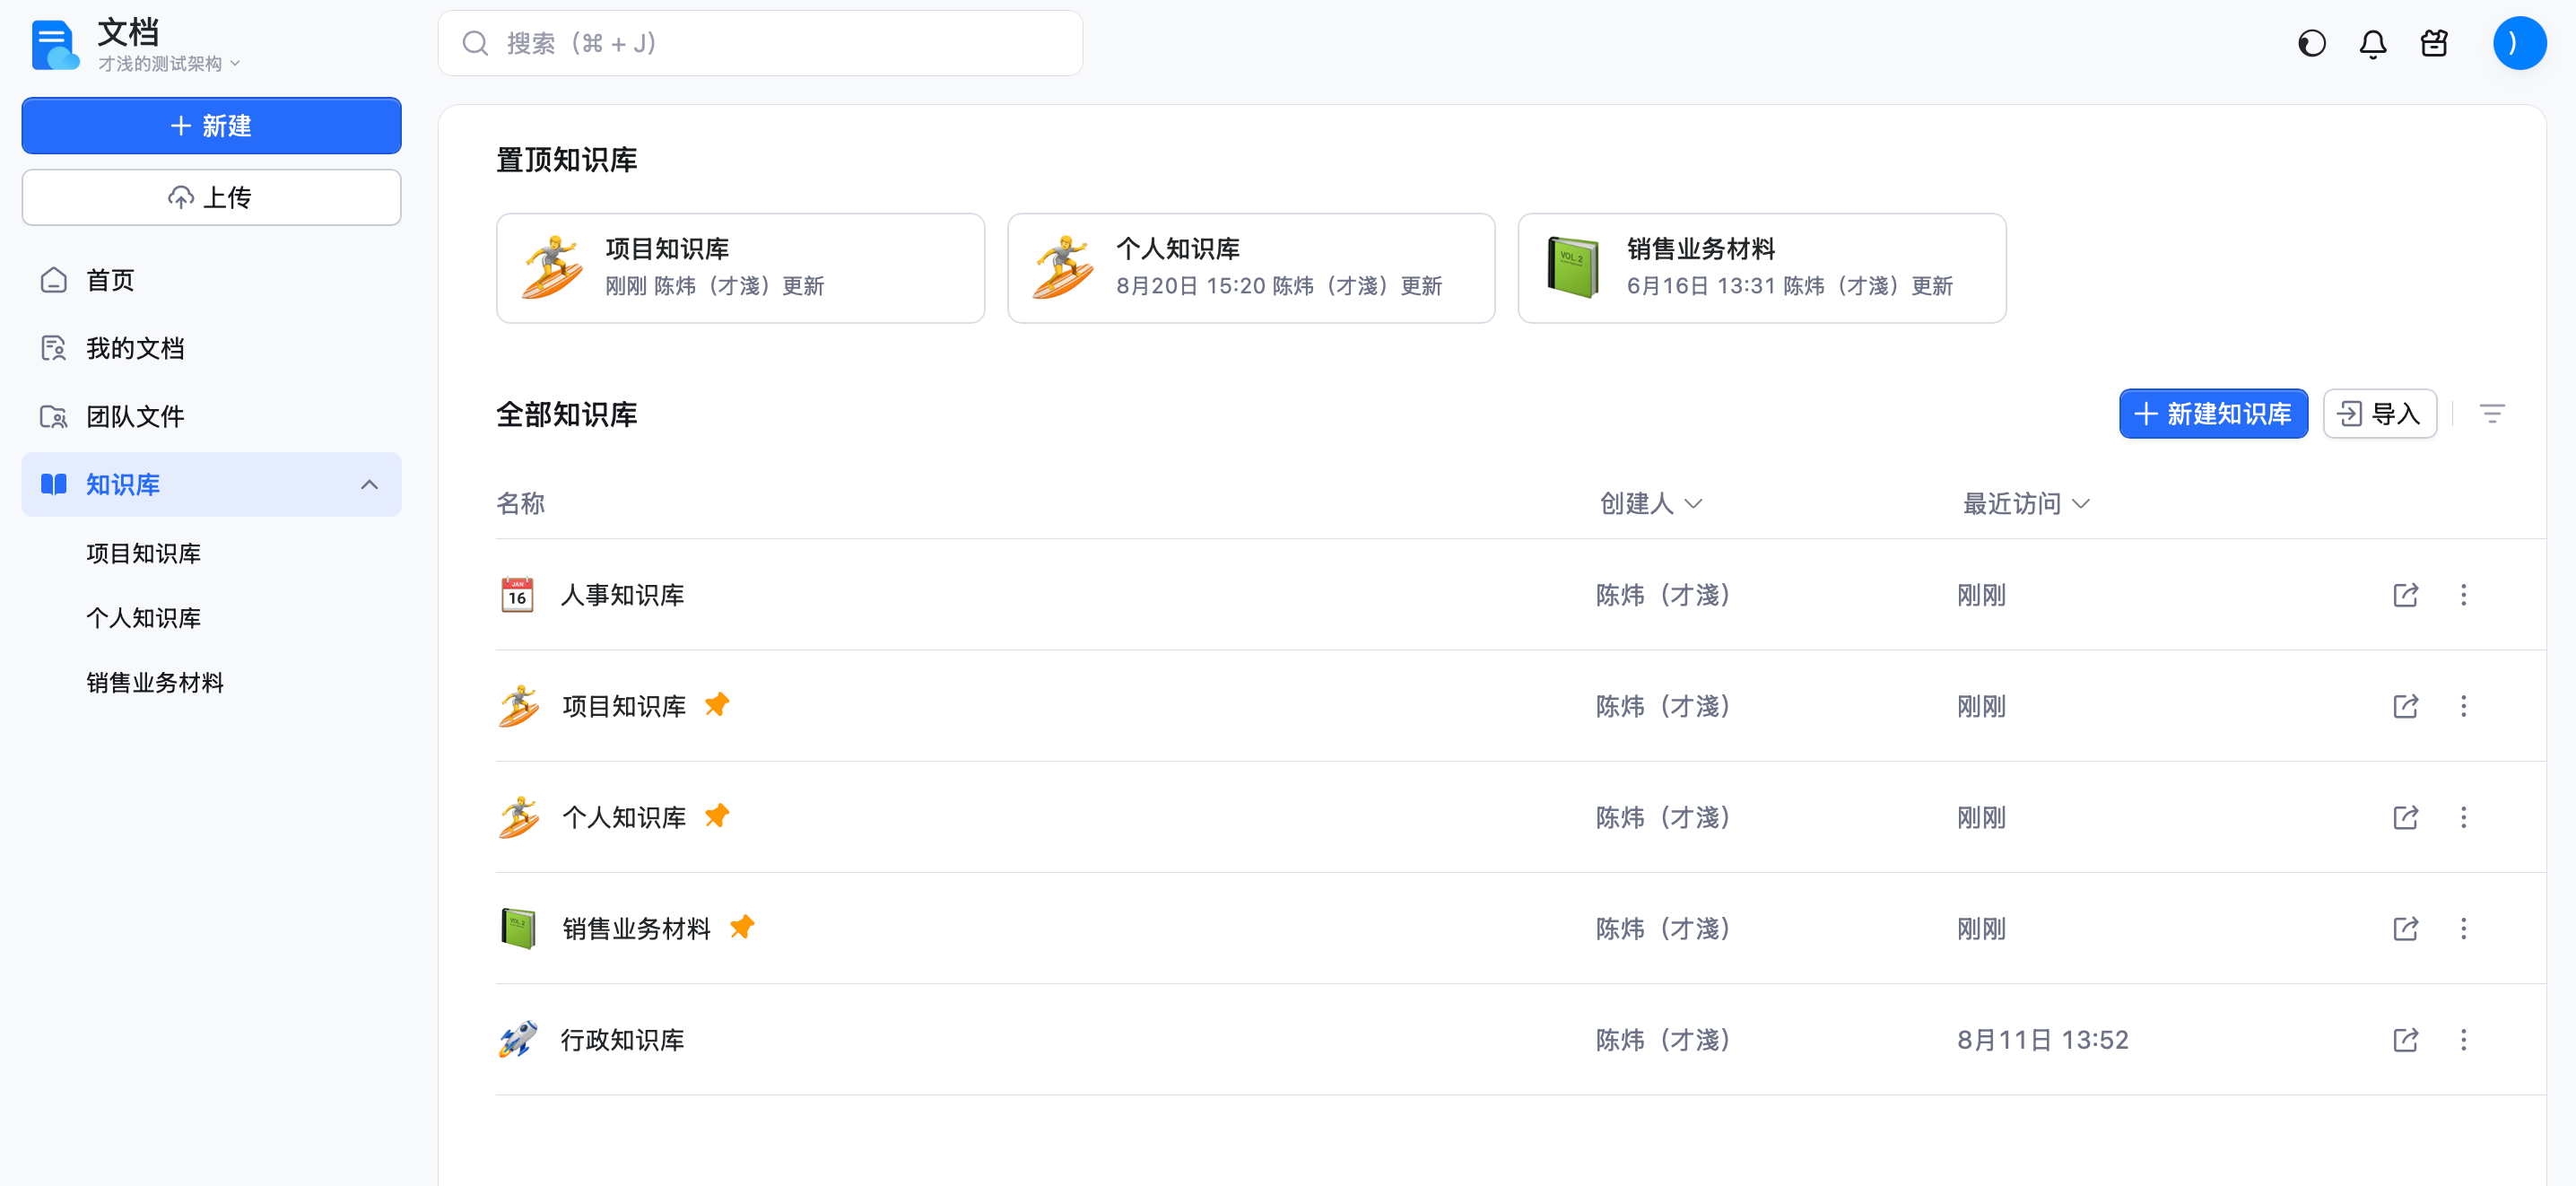
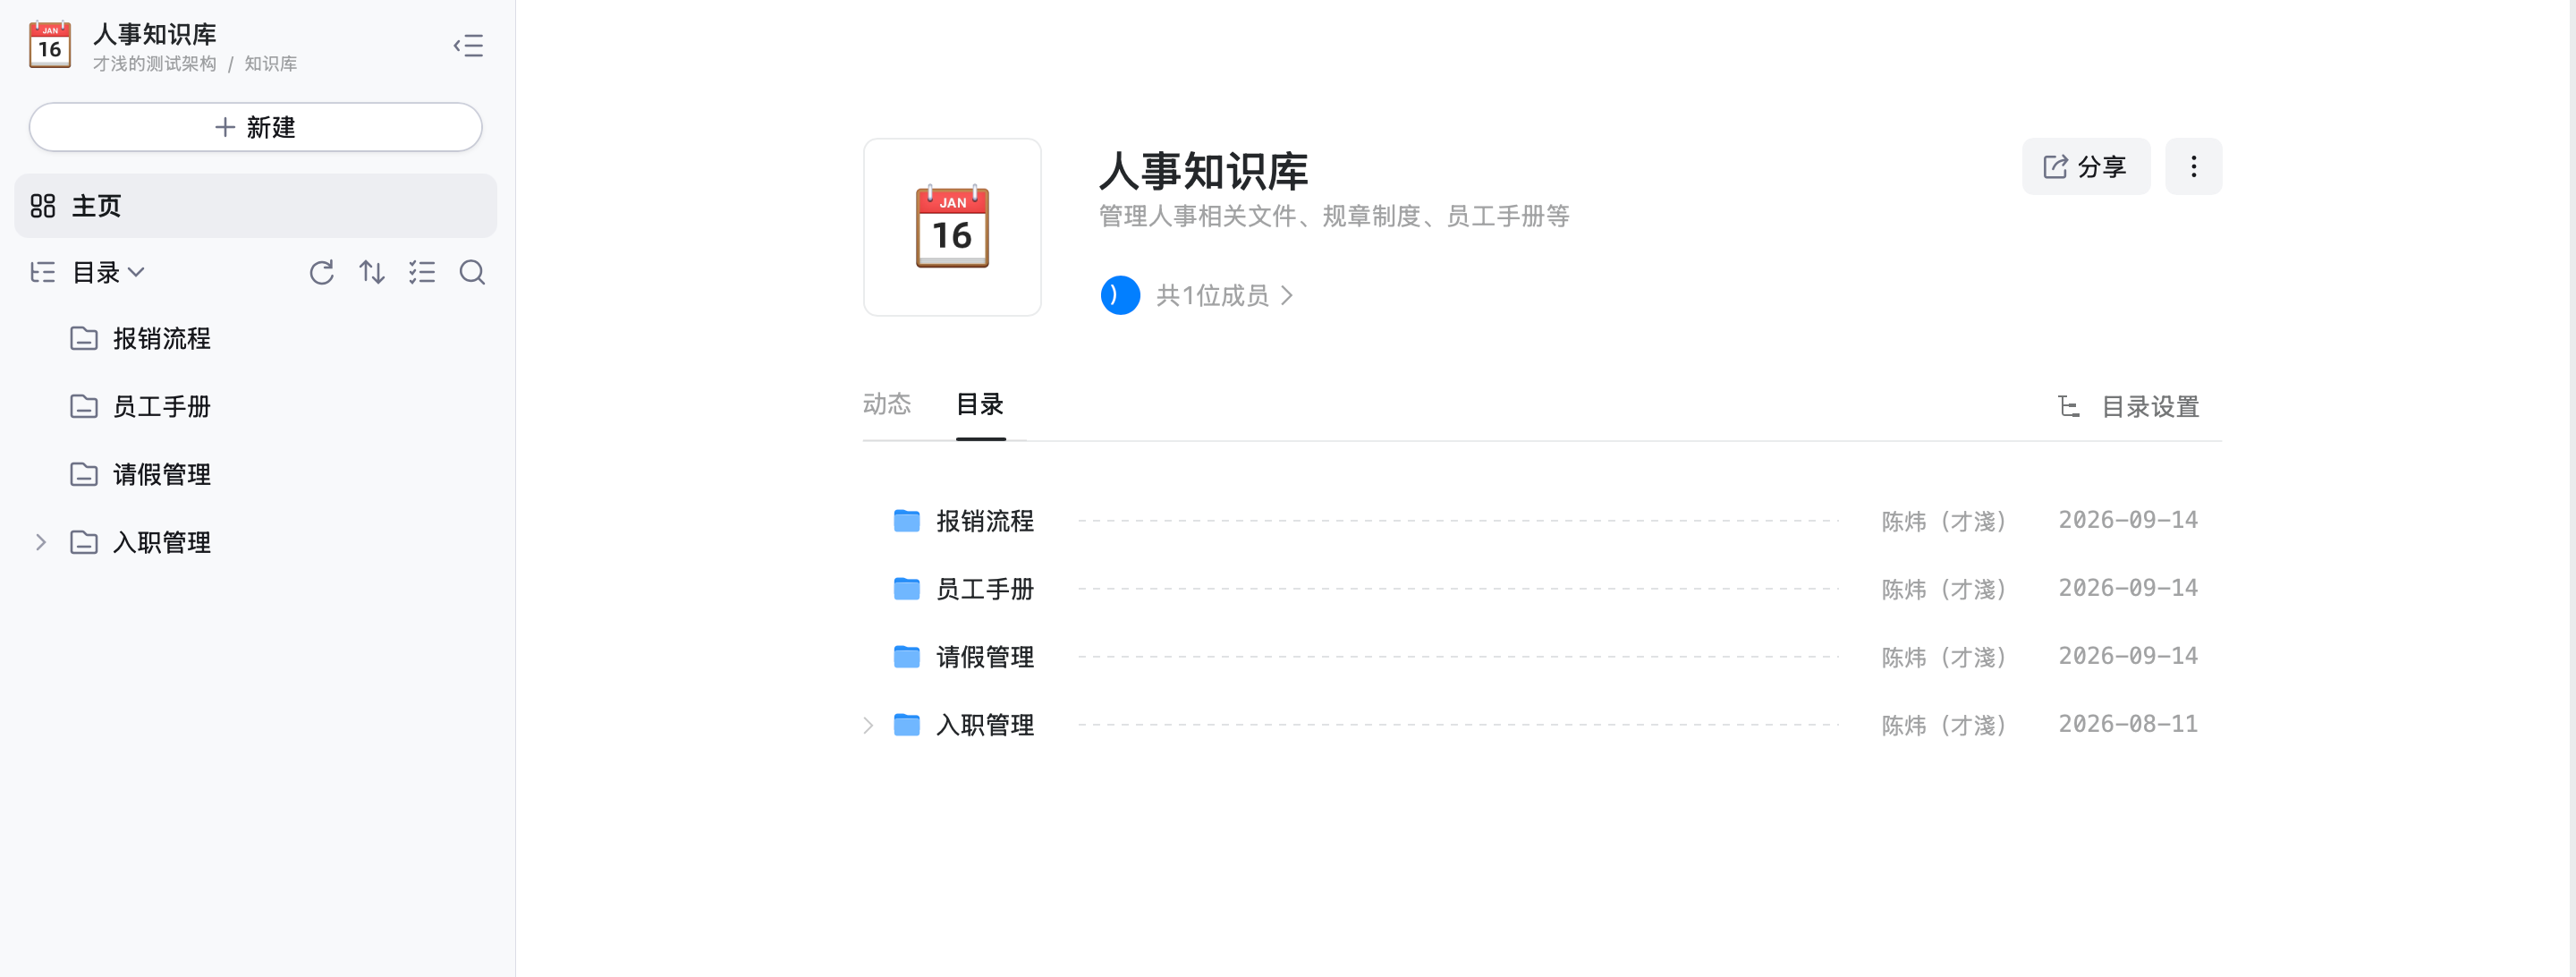
通过钉钉知识库配置与智能问答截图,展示从知识管理到员工咨询的实际产品界面。
配置演示使用实际钉钉知识库页面:先在文档工作台进入知识库,再打开人事知识库目录,最后查看具体文档内容作为问答来源。
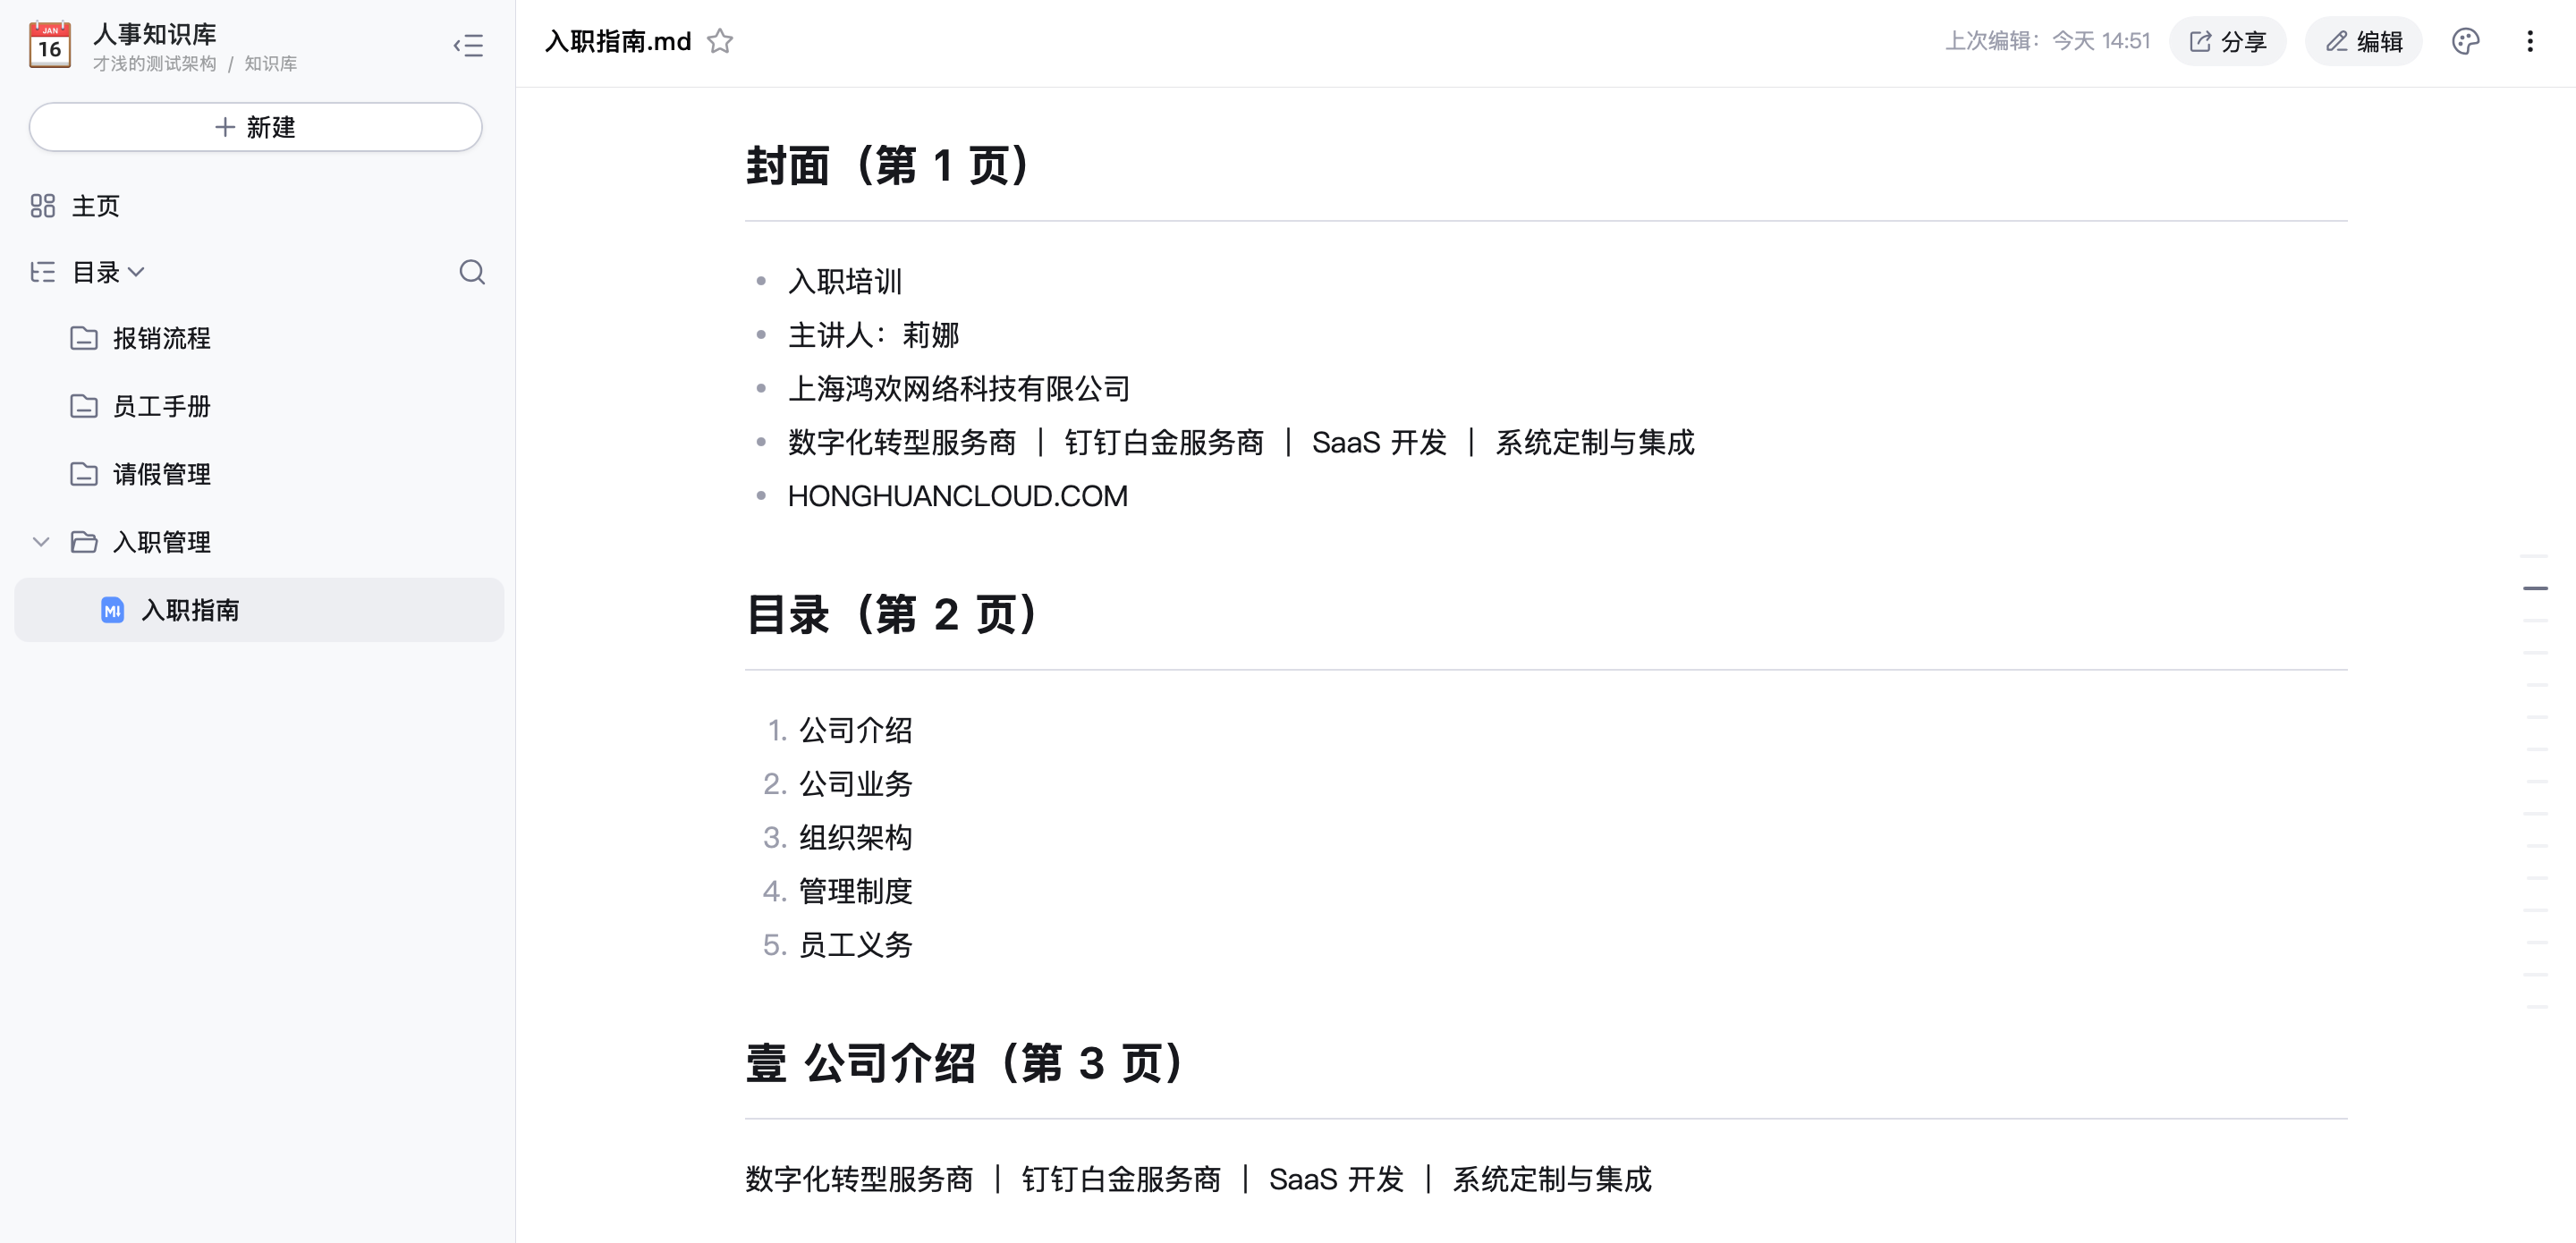
员工直接提出业务问题,系统基于知识库内容生成结构化答案,适合制度、流程、人事、绩效等高频咨询。